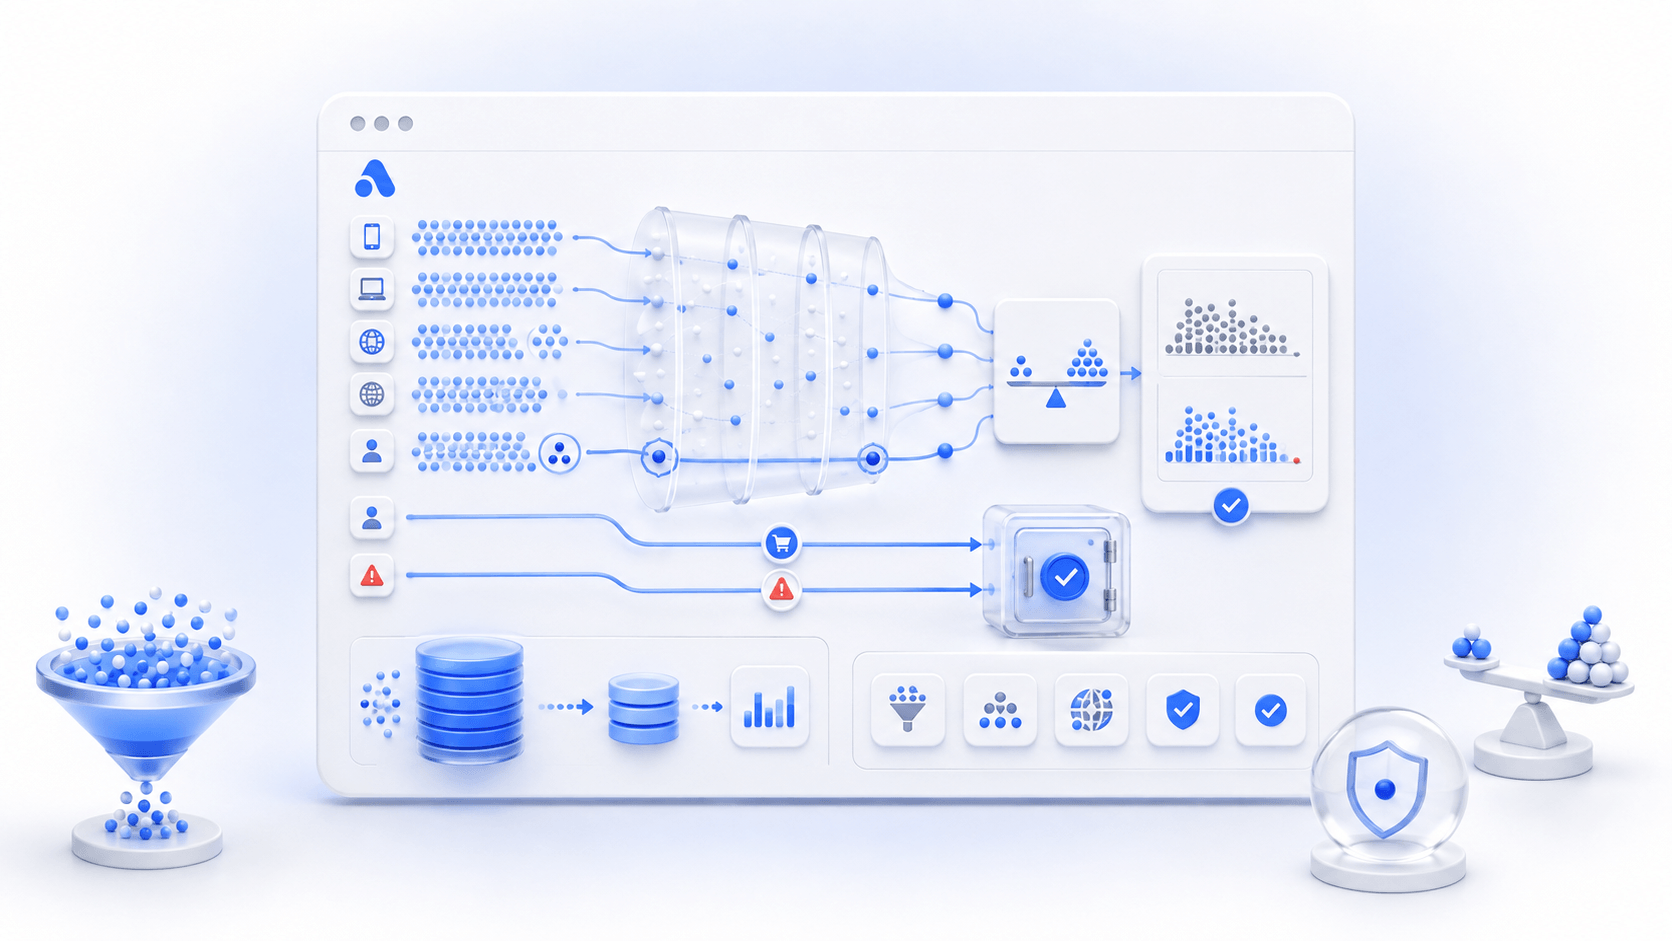
Sampling در Analytics چیست؟ Sampling در Analytics یعنی کاهش حجم پردازش با انتخاب نمونه نماینده، همراه با وزندهی و نگهداری کامل رخدادهای حیاتی. این مفهوم زمانی ارزش دارد که به یک سؤال تصمیمپذیر وصل شود: «کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟» در اجرا، رویدادها و تعریف مخرج باید ثابت باشند، داده پیش از تفسیر کنترل شود و نتیجه برای سگمنتهای مرتبط جدا دیده شود.
Sampling در Analytics دقیقاً چه معنایی دارد؟
در این مقاله، Sampling در Analytics به معنای کاهش حجم پردازش با انتخاب نمونه نماینده، همراه با وزندهی و نگهداری کامل رخدادهای حیاتی است. این تعریف عمداً به «تصمیم» وصل شده؛ چون اندازهگیری بدون مصرفکننده مشخص بهسرعت به انبار نمودار تبدیل میشود. سؤال محوری ما این است: کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟ اگر پاسخ هیچ انتخابی را تغییر نمیدهد، احتمالاً هنوز سؤال بهاندازه کافی عملی نیست.
واحد مشاهده پیشنهادی این موضوع بر پایه «ثبت کامل خرید و خطاهای بحرانی؛ نمونهگیری احتمالی replay و رخدادهای پرتکرار با نرخ معلوم» شکل میگیرد. این عبارت یک قرارداد اولیه است، نه دستور پیادهسازی نهایی. گروه باید مشخص کند رخداد دقیقاً چه زمانی ارسال میشود، چه کسی واجدشرط است، تکرار چگونه کنترل میشود و کدام سیستم مرجع نتیجه را تأیید میکند. محدودیتهای جمعآوری سیگنال ثبتشده در Google Analytics نیز نشان میدهد که تعریف سیگنال ثبتشده یا گزارش فقط نام یک فیلد نیست و زمینه جمعآوری بر تفسیر اثر دارد.
دو تفکیک را از ابتدا روشن نگه دارید. نخست، مشاهده با علت تفاوت دارد؛ دیدن همزمان دو الگوی تعامل بهصورت مستقل ثابت نمیکند یکی دیگری را ایجاد کرده است. دوم، دقت عدد با صحت تعریف یکسان نیست. داشبورد میتواند عدد را تا چند رقم اعشار نشان دهد اما اگر مخرج یا eligibility مبهم باشد، همان دقت ظاهری اعتماد کاذب میسازد.
چرا این موضوع برای کسبوکار مهم است؟
اهمیت Sampling در Analytics از جایی شروع میشود که تیم باید میان چند اقدام رقابتی انتخاب کند. اگر داده به زبان گزینه اقدام ترجمه نشده باشد، بلندترین صدا یا آخرین نمونه دیدهشده اولویت را تعیین میکند. تعریف روشن کمک میکند مسئلهای که به درآمد، فعالسازی، تجربه یا ریسک نزدیکتر است زودتر دیده شود و اصلاح تزئینی جای مانع واقعی را نگیرد.
برای مثال، این سناریو را در نظر بگیرید: یک محصول فرضی فقط ۱۰ درصد نشستها را تصادفی نگه میدارد و خطای نادر مرورگر قدیمی از نمونه حذف میشود. این مثال آموزشی است و اعداد یا نتیجه آن نباید به کسبوکار دیگری تعمیم داده شود. ارزش مثال در روش تشخیص است: تعریف را بررسی میکنیم، مسیر را به سگمنتهای معنادار میشکنیم، شواهد رفتاری را کنار عدد قرار میدهیم و فقط بعد یک فرضیه مینویسیم.
این موضوع در خوشه «زیرساخت اندازهگیری و کیفیت داده» قرار میگیرد. برای دیدن لایه وسیعتر، راهنمای بررسی کنش افراد استفادهکننده سایت را بخوانید؛ برای آشنایی با راهکار محصول نیز (لینک پیشنهادی پس از انتشار)ابزار بررسی کنش افراد استفادهکننده آلفانا نقطه شروع مرتبطی است.
چه چیزهایی را اندازه بگیریم؟
| معیار پیشنهادی | تفسیر عملی | کاربرد درست |
|---|---|---|
| نرخ پوشش | سهم جمعیت قابلنمایش در نمونه | تصمیم یا هشدار، نه قضاوت مستقل |
| خطای برآورد | فاصله نمونه و شمارش کامل | تصمیم یا هشدار، نه قضاوت مستقل |
| پوشش دم بلند | حضور سگمنتهای کمحجم | تصمیم یا هشدار، نه قضاوت مستقل |
| هزینه هر بینش | مصرف ذخیرهسازی نسبت به یافته | تصمیم یا هشدار، نه قضاوت مستقل |
خواندن معیارهای Sampling در Analytics در کنار هم
بهجای انتخاب یک KPI تنها، این چهار سیگنال را در یک نمای کوچک کنار هم بگذارید. اختلاف جهت آنها معمولاً از خود عدد مهمتر است.
۱. نرخ پوشش
نقش نرخ پوشش مشاهده سهم جمعیت قابلنمایش در نمونه است. مقدار خام را همراه با مخرج، بازه و وضعیت سلامت ورودی نمایش دهید؛ وگرنه تغییر آن توضیحپذیر نیست.
برای تفسیر، مقدار کلی را کنار تجربه گروههای کشور، دستگاه، نوع کاربر، سطح فعالیت و مسیرهای کمحجم قرار دهید. تفاوت پایدار میتواند فرضیه بسازد، اما پیش از اقدام پرهزینه توضیحهای جایگزین را حذف کنید.
۲. خطای برآورد
نقش خطای برآورد مشاهده فاصله نمونه و شمارش کامل است. مقدار خام را همراه با مخرج، بازه و وضعیت سلامت ورودی نمایش دهید؛ وگرنه تغییر آن توضیحپذیر نیست.
این عدد بهتنهایی مقصود مناسبی نیست. یک شاخص نگهبان انتخاب کنید تا بهبود ظاهری باعث افت کیفیت، اعتماد یا نتیجه پاییندست نشود؛ نتیجه را نیز در پنجره طبیعی کنش بخوانید.
۳. پوشش دم بلند
نقش پوشش دم بلند مشاهده حضور سگمنتهای کمحجم است. مقدار خام را همراه با مخرج، بازه و وضعیت سلامت ورودی نمایش دهید؛ وگرنه تغییر آن توضیحپذیر نیست.
آستانه هشدار باید به انتخاب «کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟» متصل باشد. در صورت عبور، مالک داده صحت instrumentation را کنترل کند و مالک محصول دامنه تجربه را با شواهد مکمل بسنجد.
۴. هزینه هر بینش
سنجه هزینه هر بینش روی مصرف ذخیرهسازی نسبت به یافته تمرکز دارد. پیش از تعیین هدف، توزیع تاریخی و تفاوت سگمنتها را ببینید تا آستانه دلخواه به واقعیت داده تحمیل نشود.
این عدد بدون شاهد مکمل هدف عملیاتی مناسبی نیست. یک شاخص نگهبان انتخاب کنید تا بهبود ظاهری باعث افت کیفیت، اعتماد یا نتیجه پاییندست نشود؛ نتیجه را نیز در پنجره طبیعی تعامل بخوانید.
لنز فنی: قرارداد، lineage و بدهی تحلیلی
در Sampling در Analytics باید بدانید هر فیلد از کدام component یا سرویس میآید، در چه مرحلهای تبدیل میشود و کدام خروجی گزارش مصرفکننده آن است. یک lineage ساده از «ثبت کامل خرید و خطاهای بحرانی؛ نمونهگیری احتمالی replay و رخدادهای پرتکرار با نرخ معلوم» تا داشبورد رسم کنید. این نقشه هنگام تغییر SDK یا schema نشان میدهد کدام مصرفکننده نیاز به migration دارد.
بدهی تحلیلی را در backlog فنی قابلمشاهده کنید: سیگنال ثبتشده تکراری، ویژگی بدون مالک، تعریف ناسازگار و تست ناقص. اولویت را با نزدیکی به تصمیم «کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟» تعیین کنید. پاکسازی یک رخداد حیاتی بهطور معمول از افزودن ده رخداد کممصرف ارزش بیشتری دارد.
گردشکار هفتمرحلهای از داده تا تصمیم
۱. تعریف را کنار گزارش نگه دارید
سؤال «کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟» را در ابتدای سند بنویسید و مشخص کنید پاسخ آن چه انتخابی را تغییر میدهد. انتخاب میتواند اصلاح یک مانع، توقف یک کمپین، بازطراحی یک مرحله، یا جمعآوری شواهد بیشتر باشد. اگر چند انتخاب کاملاً متفاوت زیر یک سؤال جمع شدهاند، موضوع را خرد کنید تا هر واکاوی یک مالک و نتیجه روشن داشته باشد.
۲. قرارداد اندازهگیری بسازید
event یا ورودی اصلی این تحلیل «ثبت کامل خرید و خطاهای بحرانی؛ نمونهگیری احتمالی replay و رخدادهای پرتکرار با نرخ معلوم» است. برای هر جزء، نام، تعریف، زمان ارسال، ویژگیهای لازم، نوع داده، مقدارهای مجاز، محیط، مالک و نمونه آزمون را ثبت کنید. نام را به متن متغیر دکمه وابسته نکنید؛ معنا باید با تغییر copy یا ظاهر رابط پابرجا بماند.
کنترل جمعآوری داده در PostHog را بهعنوان مرجع بیرونی بخوانید، اما قرارداد داخلی خودتان را بر اساس سؤال و معماری محصول بنویسید. ابزارهای مختلف تعریفها و محدودیتهای متفاوت دارند. مهاجرت آینده بسیار سادهتر است اگر معنا در Tracking Plan شما زندگی کند، نه فقط در تنظیمات یک داشبورد.
۳. مسیر واقعی را کنترل کیفیت کنید
پیش از آنکه نمودار را بخوانید، یک یا چند سناریوی کنترلشده را در محیط مناسب طی کنید. شناسه رخداد، ترتیب، timestamp، ویژگیها و نتیجه backend را تطبیق دهید. مسیر شکست، retry، refresh، برگشت مرورگر و دوبارکلیک را هم آزمایش کنید؛ بسیاری از دوشماریها در happy path دیده نمیشوند.
۴. مقایسه منصفانه با سگمنت هدف بسازید
ارزیابی را بر اساس کشور، دستگاه، نوع فرد، سطح فعالیت و مسیرهای کمحجم ببینید، اما هر برش را تفسیر نکنید. ابتدا بنویسید چرا انتظار دارید تجربه این گروه متفاوت باشد. سپس حجم، ترکیب و پنجره زمانی را بررسی کنید. گروه کوچک میتواند سرنخ کیفی مهمی بدهد، ولی برای ادعای آماری یا تعمیم نیازمند احتیاط است.
۵. عدد را با رفتار و زمینه تکمیل کنید
بعد از محدودشدن دامنه مسئله، هیتمپ، بازپخش نشست، خطا، جستوجوی داخلی، تیکت پشتیبانی یا مصاحبه را هدفمند بررسی کنید. تماشای تصادفی نشستها روش نمونهگیری نیست. دلیل انتخاب هر نمونه را ثبت کنید: رخداد شکستخورده، دستگاه خاص، ریزش مرحله یا نسخه مشخص.
۶. اقدام را به شکل فرضیه تعریف کنید
اقدام پیشنهادی این موضوع «تعریف strata، نرخ نمونه برای هر طبقه، ثبت sampling_rate و مقایسه با دوره کامل» است. آن را به قالبی قابلبررسی تبدیل کنید: «برای [بخش تحلیلی]، اگر [تغییر] را انجام دهیم، انتظار داریم [کنش] در [پنجره] بهتر شود، چون [شواهد]؛ درحالیکه [نگهبان] نباید بدتر شود.» این قالب تفاوت میان ایده و آزمایش را روشن میکند.
۷. مالک تصمیم را معلوم کنید
ارزیابی بعدی باید مخرج و گروه تحلیلی اولیه را حفظ کند. تاریخ انتشار، تغییر کمپین، incident و هر عامل مخدوشکننده را کنار نمودار علامت بزنید. اگر نتیجه خلاف انتظار بود، بررسی شکستخورده نیست؛ اطلاعاتی درباره مدل ذهنی تیم مسئول به دست آمده است.
مثال عملی مرحلهبهمرحله
فرض کنید یک محصول فرضی فقط ۱۰ درصد نشستها را تصادفی نگه میدارد و خطای نادر مرورگر قدیمی از نمونه حذف میشود. تیم ابتدا نرخ کلی را میبیند و وسوسه میشود سریع طراحی را تغییر دهد. تحلیلگر پیش از آن تعریف رخداد و مخرج را کنترل میکند و یک اجرای مصنوعی انجام میدهد. سپس داده را بر اساس کشور، دستگاه، نوع کاربر، سطح فعالیت و مسیرهای کمحجم جدا میکند تا بداند مسئله عمومی است یا در زمینه خاصی متمرکز شده است.
در مرحله بعد چند نمونه هدفمند انتخاب میشود: نشستهایی که رخداد مورد انتظار را ندارند، کاربرانی که چند بار retry کردهاند، یا مسیرهایی که به خروج منتهی شدهاند. تیم مسئول فقط الگوی قابلمشاهده را ثبت میکند و از نسبتدادن احساس یا قصد قطعی به فرد پرهیز دارد. اگر چند منبع—مثلاً افت مرحله، خطای فنی و الگوی تعامل تکراری—همجهت شوند، فرضیه دقیقتر میشود.
سپس یک تغییر محدود و قابلبرگشت بر اساس «تعریف strata، نرخ نمونه برای هر طبقه، ثبت sampling_rate و مقایسه تحلیلی با دوره کامل» تعریف میشود. شاخص نتیجه یکی از جدول بالاست و یک شاخص نگهبان نیز انتخاب میشود. همه اعداد این سناریو فرضیاند؛ در محصول واقعی باید اندازه نمونه، فصل، طول چرخه و هزینه خطا را لحاظ کرد. هدف عملیاتی مثال، نشاندادن جریان منظم از نشانه تا تصمیم است، نه وعده رشد.
چگونه از همبستگی به ادعای علت نپریم؟
مرور گزارشهای تحلیلی Mixpanel چارچوب یا محدودیت مکملی برای این حوزه ارائه میکند. استفاده از منبع رسمی به معنی انتقال مستقیم همه توصیهها نیست؛ زمینه حقوقی، فنی و محصول شما ممکن است متفاوت باشد. ادعا را تا سطحی نگه دارید که داده واقعاً پشتیبانی میکند: «در این گروه تحلیلی همراه بود»، «پس از تغییر دیده شد» یا «در آزمایش با شرایط مشخص تفاوت داشت.»
پنج خطای متناسب با Sampling در Analytics
۱. Cardinality کنترلنشده
ویژگی آزاد با هزاران مقدار، گزارش تحلیلی و هزینه پردازش را سنگین میکند و مقایسه پایدار نمیماند. راه اصلاح، افزودن نمودار بیشتر نیست. دامنه را کوچک کنید، اقدام «تعریف strata، نرخ نمونه برای هر طبقه، ثبت sampling_rate و مقایسه با دوره کامل» را به قرارداد قابلآزمون تبدیل و اثر پاییندست را کنترل کنید.
۲. وابستگی تعریف به رابط
نام رخداد به متن دکمه یا جایگاه موقت وابسته است و با redesign معنای تاریخی از بین میرود. در گزارش، ملاحظه را آشکار بنویسید و توضیح دهید این نقص چگونه پاسخ سؤال «کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟» را تغییر میدهد.
۳. نبود reconciliation
نتیجه analytics با پایگاه سفارش، اشتراک یا سیستم مرجع تطبیق داده نمیشود و خطای خام پنهان میماند. برای پیشگیری، تعریف و مالک را کنار گزارش ثبت کنید و توالی «ثبت کامل خرید و خطاهای بحرانی؛ نمونهگیری احتمالی replay و رخدادهای پرتکرار با نرخ معلوم» را در نسخه واقعی دوباره آزمایش کنید.
۴. تغییر بینسخه
schema یا منطق eligibility عوض میشود اما نمودار قبل و بعد یک سری پیوسته نمایش داده میشود. در گزارش تحلیلی، محدودیت را آشکار بنویسید و توضیح دهید این نقص چگونه پاسخ سؤال «کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟» را تغییر میدهد.
۵. جمعآوری پیش از سؤال
گروه همه چیز را ثبت میکند و بعد میان صدها رخداد دنبال کاربرد میگردد؛ هزینه بالا و مالکیت پایین میماند. برای پیشگیری، تعریف و مالک را کنار گزارش تحلیلی ثبت کنید و جریان «ثبت کامل خرید و خطاهای بحرانی؛ نمونهگیری احتمالی replay و رخدادهای پرتکرار با نرخ معلوم» را در نسخه واقعی دوباره آزمایش کنید.
الگوی جلسه و داشبورد عملیاتی
یک صفحه تصمیممحور برای cadence هفتگی کافی است: وضعیت شاخص نتیجه، دو محرک، یک نگهبان، سلامت داده و فهرست تغییرهای مهم. هر نمودار باید مالک و آستانه داشته باشد. رنگ قرمز بدون تعریف اینکه چه کسی چه کاری انجام میدهد فقط اضطراب تولید میکند.
برای ساختن این چرخه میتوانید از پلتفرم فارسی ارزیابی الگوی تعامل و محصول آلفانا و مستندات آلفانا شروع کنید. ابزار جای تعریف و مسئولیت را نمیگیرد، اما وقتی قیف، الگوی تعامل صفحه و نشست در کنار هم باشند، زبان مشترک تیم مسئول سریعتر شکل میگیرد.
چکلیست اجرای Sampling در Analytics
- سؤال تصمیم و مخاطب گزارش را یکخطی بنویسید.
- واحد تحلیل، مخرج، eligibility و پنجره زمانی را ثبت کنید.
- رخداد «ثبت کامل خرید و خطاهای بحرانی؛ نمونهگیری احتمالی replay و رخدادهای پرتکرار با نرخ معلوم» را در مسیر موفق و شکست آزمایش کنید.
- مالک رویداد و مالک تصمیم را جداگانه مشخص کنید.
- معیار نتیجه، محرک، نگهبان و سلامت داده داشته باشید.
- تحلیل را فقط با سگمنتهای فرضیهمحور انجام دهید.
- تغییر ترکیب ترافیک و نسخه محصول را کنترل کنید.
- نمونههای رفتاری را بر اساس دلیل روشن انتخاب کنید.
- داده حساس غیرضروری را ثبت نکنید و دسترسی را محدود سازید.
- هر عدد فرضی یا برآورد را آشکار برچسب بزنید.
- اقدام، موعد و شرط بازبینی را در خروجی بنویسید.
- نتیجه مثبت، منفی یا خنثی را در تاریخچه یادگیری نگه دارید.
مسیر پیشنهادی اجرای Sampling در Analytics چیست
برای تبدیل این موضوع به یک کار قابل پیگیری، مراحل زیر را بهترتیب اجرا کنید. ترتیب به تیم کمک میکند پیش از تفسیر، تعریف و کیفیت داده را کنترل کند و خروجی را به تصمیمی دارای مالک برساند.
- در آغاز کار روی Sampling در Analytics چیست، سؤال تصمیم را پیش از انتخاب ابزار بنویسید و دقیق بنویسید کدام عدد یا مشاهده میتواند واقعاً مسیر محصول را مداخله دهد.
- برای سنجش Sampling در Analytics چیست، رویداد، ویژگی، جمعیت واجدشرط، مخرج و پنجره زمانی را در یک قرارداد اندازهگیری نسخهدار مستند کنید.
- پیش از تفسیر Sampling در Analytics چیست، مسیر موفق، شکست، تکرار، بازگشت و محیط آزمایشی را صحتسنجی کنید تا داده ناسالم وارد تحلیل نشود.
- در تحلیل Sampling در Analytics چیست، برآیند را فقط برای سگمنتهای دارای فرضیه مقایسه و تفاوت اندازهگیری را از تفاوت واقعی رفتار جدا کنید.
- برای تصمیم نهایی درباره Sampling در Analytics چیست، یافته را به اقدام کوچک، مالک، معیار خروجی، شاخص نگهبان و تاریخ بازبینی بعدی متصل کنید.
مرز داده قطعی و تفسیر در Sampling در Analytics چیست
گزارش Sampling در Analytics چیست زمانی قابل اتکاتر است که Fact، Interpretation و Causality در یک سطح نوشته نشوند. داده خام محل سؤال را نشان میدهد؛ توضیح چرایی باید با زمینه، منبع مستقل و روش مناسب پشتیبانی شود.
| نوع گزاره | نمونه بیان درست | اقدام بعدی |
|---|---|---|
| داده مشاهدهشده | در این بازه و برای این سگمنت، رویداد یا الگوی مشخص ثبت شده است. | تعریف، مخرج، نسخه و سلامت ورودی را کنترل کنید. |
| تفسیر | این الگو میتواند با اصطکاک، پیام نامتناسب یا محدودیت فنی مرتبط باشد. | شواهد مستقل و توضیحهای جایگزین را بررسی کنید. |
| ادعای علّی | فقط طراحی مناسب آزمایش یا شواهد کافی میتواند اثر مداخله را پشتیبانی کند. | معیار نتیجه و شاخص نگهبان را پیش از اجرا ثبت کنید. |
مزایا و محدودیتهای Sampling در Analytics چیست
در ارزیابی Sampling در Analytics چیست، فقط فهرست مزایا کافی نیست. هر قابلیت تحلیلی یک پیششرط و یک ریسک تفسیر دارد؛ جدول زیر این دو سوی تصمیم را کنار هم نگه میدارد تا خروجی به نسخه واحد برای همه کسبوکارها تبدیل نشود.
| جنبه | مزیت عملی | محدودیت و کنترل لازم |
|---|---|---|
| تمرکز بر رفتار واقعی | فاصله میان گزارش کلی و تجربه مسیر را کمتر میکند. | رفتار مشاهدهشده قصد قطعی کاربر را ثابت نمیکند؛ زمینه و شاهد مکمل لازم است. |
| سگمنتبندی | میانگین پنهانکننده تفاوت دستگاه، کانال یا مرحله عمر را آشکار میکند. | گروه بسیار کوچک یا انتخاب پس از دیدن نتیجه میتواند برداشت ناپایدار بسازد. |
| قابلیت اقدام | یافته را به فرضیه، مالک و معیار بازبینی متصل میکند. | بدون شاخص نگهبان، بهبود یک مرحله ممکن است تجربه پاییندست را بدتر کند. |
| سرعت یادگیری | مسئلههای پراثر را پیش از بازطراحی گسترده محدود میکند. | سرعت نباید جای کنترل کیفیت، حریم خصوصی یا بررسی علتهای جایگزین را بگیرد. |
گام بعدی: یک نشانه را تا تصمیم دنبال کنید
در اولین چرخه تنها یک تصمیم را هدف بگیرید، قرارداد داده آن را بازبینی کنید و یک سگمنت را از ابتدا تا نتیجه دنبال کنید. اگر اختلافی دیدید، آن را با حداقل یک شاهد رفتاری تکمیل و به یک اقدام دارای مالک تبدیل کنید. شعار آلفانا «هر رفتار یک نشانهست!» دقیقاً همین نگاه را خلاصه میکند: نشانه را ببینید، زمینه را بسنجید و بعد تصمیم بگیرید.
مطالب مرتبط برای ادامه مسیر تحلیلی:
- داشبورد Product Analytics چگونه طراحی میشود؟ از نمودار تا اقدام (لینک پیشنهادی پس از انتشار)
- North Star Metric چیست؟ انتخاب معیار ستاره قطبی محصول (لینک پیشنهادی پس از انتشار)
- Micro Conversion و Macro Conversion چیست؟ طراحی سلسله اهداف (لینک پیشنهادی پس از انتشار)
پرسشهای متداول درباره Sampling در Analytics چیست
Sampling در Analytics را از کجا شروع کنیم؟
از یک مسیر تحلیلی و یک سؤال مهم شروع کنید: «کدام داده را میتوان نمونهگیری کرد بدون اینکه مسئلههای کمتکرار یا گروههای کوچک ناپدید شوند؟» سپس تعریف رخداد، مخرج و معیار نتیجه را بنویسید و یک اجرای کنترلشده انجام دهید. پوشش کامل همه سایت در روز اول لازم نیست. دامنه کوچک، داده سالم و مالک مشخص بهطور معمول از داشبورد بزرگ بدون اقدام مفیدتر است.
برای نتیجهگیری چه مقدار داده لازم است؟
برای حجم لازم یک عدد جهانی نداریم. نوع معیار، نرخ پایه، اندازه اثر مورد انتظار، پراکندگی، فصل و ریسک گزینه اقدام اثر دارند. برای کشف bug میتوان با نمونه کوچک هدفمند شروع کرد؛ برای ادعای آماری یا تغییر پرهزینه باید طراحی و توان آزمون مناسب داشت. کمبود داده را با قطعیت زبانی پنهان نکنید.
مهمترین سگمنتها برای این تحلیل کداماند؟
نقطه شروع این مقاله «کشور، دستگاه، نوع کاربر، سطح فعالیت و مسیرهای کمحجم» است، اما فقط گروهی را جدا کنید که دلیل معقولی برای تفاوت تجربهاش دارید. دستگاه، نسخه، کانال و کاربر جدید یا قدیمی اغلب مفیدند. از ساخت سگمنتهای بسیار ریز که حجم و قابلیت اقدام ندارند پرهیز کنید.
آیا یک داشبورد برای این کار کافی است؟
chartها تغییر و وسعت را سریع نشان میدهند، اما علت را بهصورت مستقل ثابت نمیکند. برای تشخیص اغلب به مسیر تحلیلی، خطا، بازپخش نشست، هیتمپ، بازخورد یا تحقیق استفادهکننده نیاز دارید. ترکیب دو منبع مستقل از شواهد، فرضیه را قویتر میکند؛ هنوز هم باید مرز همبستگی و علت حفظ شود.
این تحلیل چه ملاحظه حریم خصوصی دارد؟
اصل را بر کمینهسازی داده غیرضروری بگذارید، محتوای حساس را ماسک یا حذف کنید، دسترسی و دوره نگهداری داشته باشید و اطلاعرسانی یا رضایت را مطابق قوانین قابلاعمال و سیاست سازمان بررسی کنید. این متن مشاوره حقوقی نیست؛ برای تصمیم عملیاتی الزامآور از متخصص مرتبط کمک بگیرید.
بعد از پیدا کردن مسئله چه اقدامی انجام دهیم؟
مشاهده را به فرضیه تبدیل کنید و اقدام پیشنهادی «تعریف strata، نرخ نمونه برای هر طبقه، ثبت samplingrate و ارزیابی کنارهم با دوره کامل» را با یک تغییر محدود، معیار نتیجه و شاخص نگهبان اجرا کنید. اگر اطمینان کم است، شواهد تکمیلی جمع کنید؛ اگر bug روشن و پراثر است، اصلاح مستقیم و پایش بعد از انتشار ممکن است از آزمایش مصنوعی مناسبتر باشد.
بدون دیدگاه